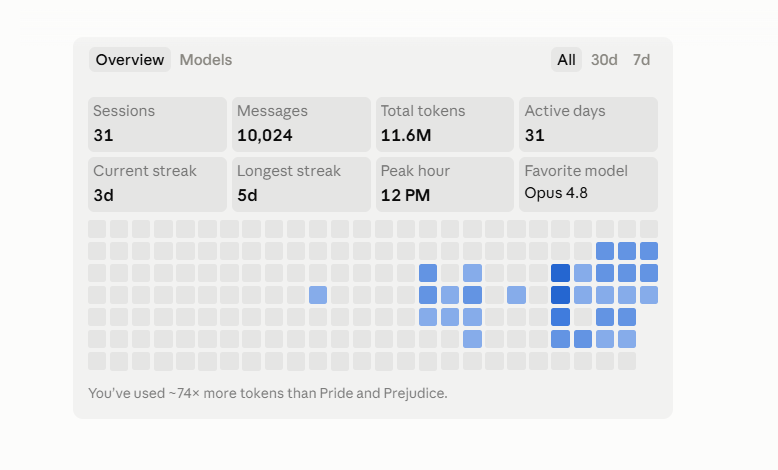
Бизнес массово подключает нейросети: в переписку с клиентами, в код, в контент. Вслед за этим приходит первый счёт за токены, и часто он неприятно большой. Токен, если совсем просто, — это единица, которой нейросеть измеряет текст: каждый запрос к ChatGPT, Claude или своему ИИ-агенту тратит их дважды, на отправленное и на ответ модели. Значит, каждый лишний абзац в промпте и каждая затянутая сессия стоят денег. Чем длиннее диалог и чем больше мусора в контексте, тем быстрее крутится счётчик.
Расход почти всегда можно срезать на треть, а то и вдвое, ничего не потеряв в качестве ответов. Разберём, как экономить токены и в рабочих инструментах вроде Cursor и Codex, и когда нейросеть работает на ваш бизнес в режиме 24/7 — а это уже другая математика.
Что такое токен в нейросети и почему их считают
Модель не видит буквы и слова так, как мы. Она разбивает текст на токены (куски от одного символа до целого слова) и дальше работает уже с ними. Механизм называется byte-pair encoding: частые сочетания символов сворачиваются в один токен, редкие дробятся на несколько. Слово apple укладывается в один токен, а blueberries распадается на два, blue и berries. В английском в среднем выходит около 0,75 слова на токен, по данным OpenAI.
Считаются обе стороны разговора: и вход (ваш промпт плюс весь переданный контекст), и выход (ответ модели). Причём выход у большинства сервисов тарифицируется дороже входа — длинный ответ бьёт по расходу сильнее, чем длинный вопрос.
Отдельная история — контекстное окно. Нейросеть не помнит прошлый разговор сама по себе: чтобы поддержать диалог, ей каждый раз заново пересылают всю переписку, прочитанные файлы и прежние ответы. То есть двадцатое сообщение в чате тащит за собой все девятнадцать предыдущих. Вот почему длинные сессии дорожают к концу, даже если вопросы простые.
И есть неприятный для нас нюанс: русский текст тратит токенов заметно больше английского. По разным замерам, в 2–3 раза на тот же смысл. Причин несколько: латиница кодируется одним байтом, а кириллица двумя; обучающие данные у моделей англоцентричны; плюс русская морфология с падежами и приставками даёт меньше повторов, которые токенизатор мог бы свернуть. (Кстати, транслитом, русским словом в латинице, токенов уходит примерно вдвое меньше, но клиенту так не ответишь.) Практический вывод: одна и та же инструкция по-русски съедает вдвое больше окна, чем по-английски.
Совет от эксперта. Системный промпт агента, служебную инструкцию, которую клиент не видит, часто выгоднее написать по-английски: расход на неё падает примерно вдвое. В самой инструкции при этом задаёте «отвечай пользователю на русском». Клиент получает русский ответ, а вы не переплачиваете за англоцентричный токенизатор на служебной части.
Что реально сжигает токены
Экономия начинается не с «пишите короче», а с понимания, куда именно утекает бюджет. По убыванию влияния:
Длина истории диалога. Главный источник расхода. Контекст держит всю переписку целиком и пересылает её на каждом шаге. Сто сообщений подряд в одной сессии обходятся дороже, чем те же сто, разбитые на десять коротких.
Лишнее в контексте. Прикреплённые файлы, целые документы, вся база знаний разом — всё это уходит в модель, даже если для ответа нужен один абзац.
Многословный вывод. Ответ «простынёй» дороже сжатого, а выход тарифицируется выше входа.
Мощная модель на простой задаче. Держать топовую модель на «ответь да/нет» — всё равно что возить одного пассажира на автобусе.
Как экономить токены в AI-инструментах
Если вы работаете в Claude, Cursor или Codex, почти весь расход упирается в одно: контекст растёт незаметно, а платите вы за него на каждом запросе.
Claude и Claude Code
Держите принцип «одна задача, одна сессия». Закончили с багом — открывайте новый чат, а не тяните старый: иначе следующий вопрос потащит за собой весь предыдущий разбор. Команда /clear сбрасывает контекст, а /context показывает, что именно съедает окно: системный промпт, подключённые файлы, MCP-серверы. Самое крупное сокращение даёт модель под задачу: перевод рутины со старшей модели на младшую экономит на ней около пяти раз.
Cursor
Сужайте запрос. «Отрефактори функцию login в auth.ts» вместо «перебери весь модуль авторизации» — меньше файлов в контексте, короче ответ, меньше токенов. Чем конкретнее скоуп, тем дешевле и точнее результат.
Codex
Не тащите в контекст весь репозиторий. Подключайте только те файлы и плагины, которые нужны для текущего шага, и чистите сессию между задачами. Разросшийся контекст здесь бьёт по расходу так же, как и везде.
Универсальные правила, которые работают везде
Инструменты разные, а логика одна. Что переносится на любую нейросеть и любого агента:
Короткий контекст дешевле длинного — не тяните историю, если она не нужна для ответа.
Правильная модель важнее самой мощной — простое отдавайте лёгкой модели.
Чёткая инструкция экономит на выходе: агент, который понимает границы, не генерирует лишнего.
По-русски — плотнее и без «воды»: каждое лишнее предложение в промпте вы оплачиваете в двойном размере.
Разово растянуть подписку в Cursor можно и руками. Но когда нейросеть отвечает клиентам без вас, ручная экономия упирается в потолок: расход начинает определять платформа, на которой собран агент. Собрать такого агента без кода реально за вечер, а вот как удержать его стоимость — вопрос отдельный.
Когда экономия вредит
Резать расход можно по-разному, и часть способов обходится дороже сэкономленного. Стоит вырезать из системного промпта правило «не знаешь, передай оператору» ради пары сотен токенов, и агент начинает выдумывать ответы. Один такой галлюцинированный ответ клиенту стоит дороже, чем вся экономия за месяц.
Где граница проходит на практике
Резать можно
Резать нельзя
Историю диалога между задачами
Защитные правила промпта (границы, эскалация)
Лишние документы в контексте
Базу знаний до состояния «агент не отвечает»
Многословие в ответах
Проверку фактов там, где цена ошибки высокая
Топ-модель на простых вопросах
Модель на сложном диалоге с возражениями
Совет от эксперта. Правило «не уверен — передавай человеку» само по себе экономит токены. Агент, который честно эскалирует сложный вопрос, не сжигает бюджет на длинный неверный ответ и не создаёт вам проблему с недовольным клиентом. Экономия и качество здесь совпадают, а не спорят.
Токены, когда нейросеть работает на бизнес
Свои токены в Cursor — это ваш личный лимит: сжёг подписку, подождал до сброса. С ИИ-агентом, который принимает заявки и отвечает клиентам круглосуточно, расход умножается на поток диалогов. И вопрос смещается: не «как растянуть подписку», а «как держать стоимость предсказуемой при сотнях разговоров в день».
Здесь работают те же принципы, но с одним усилением. Эскалация оператору экономит не только качество, но и деньги: всё, что решает человек за десять секунд, агенту обрабатывать не нужно вовсе. Компактная база знаний вместо свалки документов, чёткая роль вместо «отвечай на всё» — та же логика, только цена ошибки выше, потому что на другом конце реальный покупатель.
Как это устроено в BotHelp
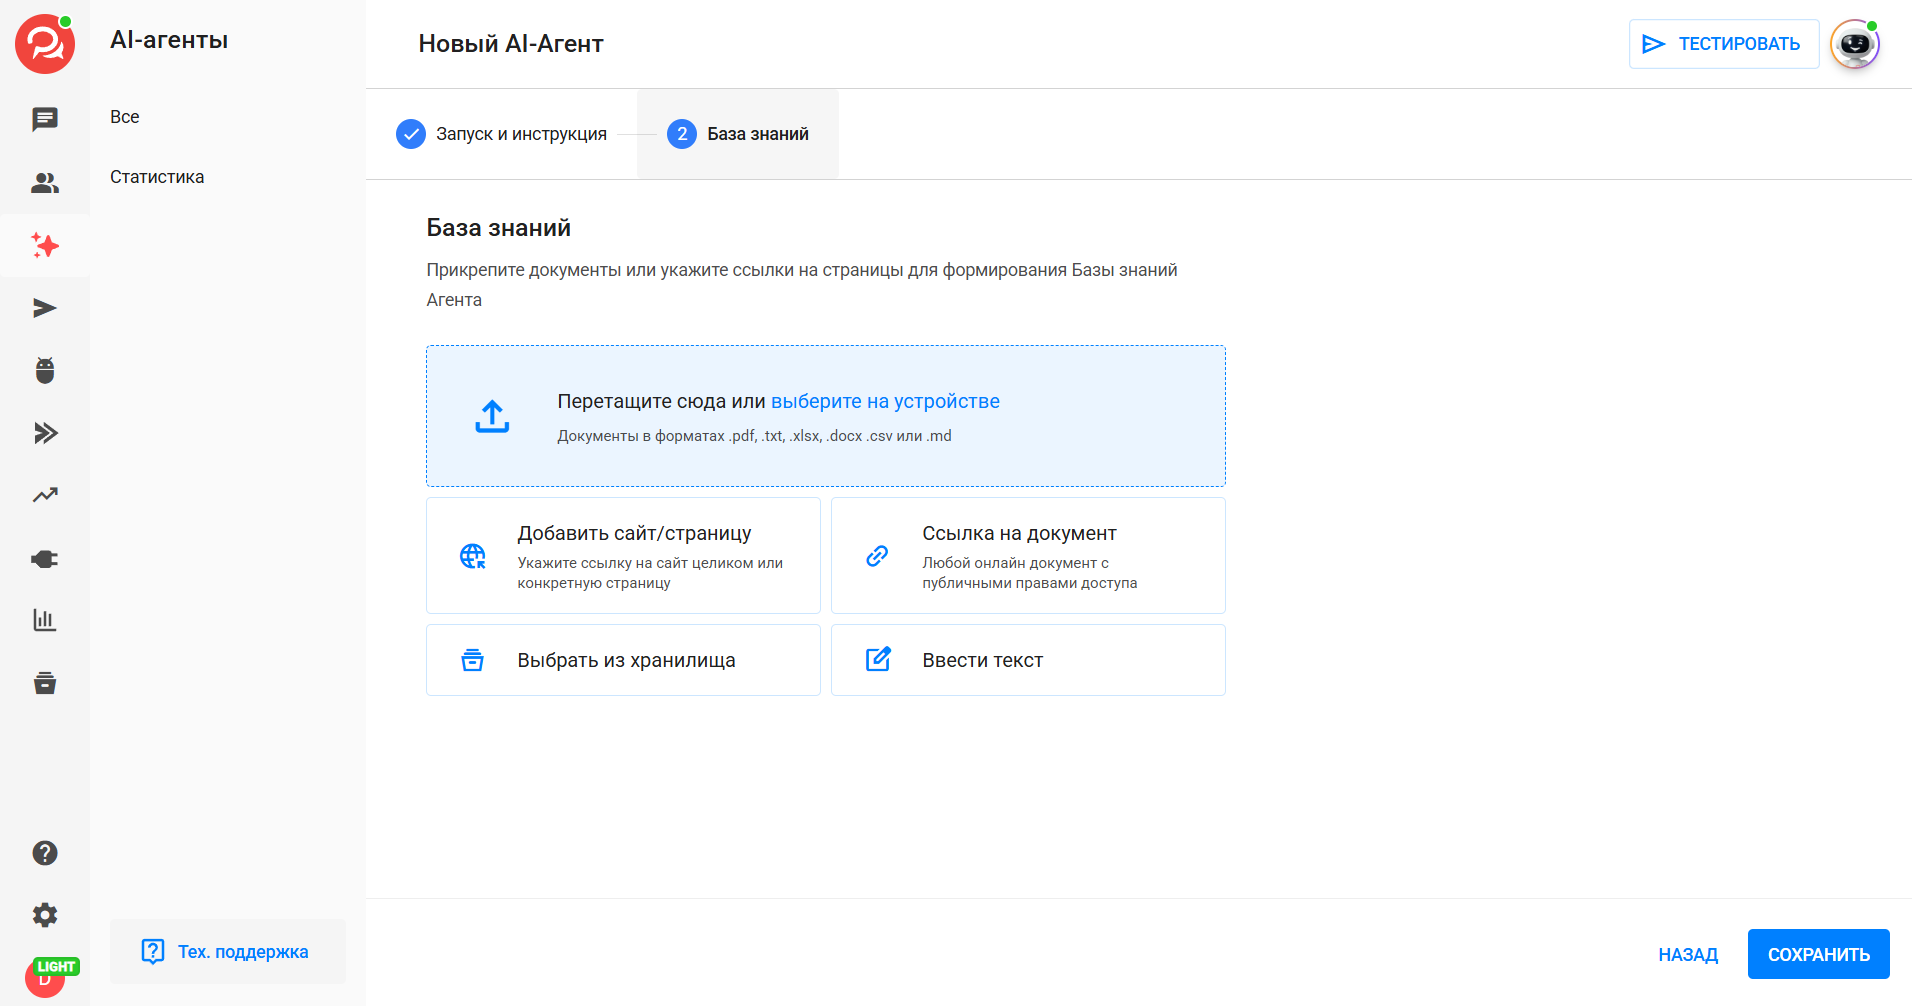
Экономия на уровне промпта — потолок того, что вы делаете руками. Дальше математику определяет платформа: как она хранит контекст, где считает токены и что вообще входит в тариф. ИИ-агент BotHelp собирается без кода, учится на ваших документах и отвечает клиентам в мессенджерах и на сайте из одного кабинета.
Ключевое отличие от работы с API нейросети напрямую — модель оплаты. При прямом подключении вы сами следите за каждым токеном, и счёт в конце месяца непредсказуем. В BotHelp AI-токены входят в тариф, а платите вы только за активных подписчиков во всех подключённых каналах. Получается понятный месячный потолок вместо сюрприза в биллинге, при том же качестве ответов.
Помогает и старт с готового шаблона: вместо того чтобы сжигать токены на отладку агента с нуля, вы берёте преднастроенную роль и правите под себя. База знаний агента держит контекст компактным: агент отвечает из ваших материалов, а не пересобирает ответ с нуля каждый раз.
Данные при этом остаются в России: серверы в РФ и соответствие 152-ФЗ, без публикации в RuStore и регистрации в реестре МСП.
Нужен агент, который отвечает клиентам и не пугает счётом за нейросеть? Соберите его на готовом шаблоне и посмотрите расход на реальных диалогах — настроить ИИ-агента.
Типичные ошибки
Ставят топовую модель везде. Самая мощная нейросеть на «уточнить адрес доставки» — прямой перерасход. Простое отдавайте лёгкой модели.
Валят всю базу знаний в один промпт. Модель получает сто страниц, чтобы ответить одним абзацем. Дробите материалы и подключайте по релевантности.
Не чистят историю диалога. Одна бесконечная сессия на всё дорожает с каждым сообщением. Разбивайте работу на короткие сессии.
Экономят на защитных правилах. Убрали границы и эскалацию ради токенов — получили галлюцинации и недовольных клиентов. Это самая дорогая «экономия».
Пишут системный промпт на две страницы «на всякий случай». Каждое лишнее правило вы оплачиваете на каждом запросе. Оставляйте только то, что реально меняет поведение.
Соберите агента, за которого не страшно платить
Экономия токенов в Cursor или Claude растягивает вашу личную подписку. Экономия в агенте, который работает на бизнес, даёт другое: предсказуемый счёт и клиентов, которые получают ответ за секунды. Загрузите свою базу знаний в готовый шаблон, задайте агенту роль и границы — и первые диалоги пройдут уже на пробном периоде.
Это кусок текста, которым нейросеть считает всё, что вы ей отправляете и что она отвечает. Токен может быть символом, частью слова или целым словом. Модель работает не с буквами, а с токенами, и по их числу считается расход.
Кириллица кодируется в два байта против одного у латиницы, а обучающие данные моделей в основном английские. В итоге тот же смысл по-русски занимает в 2–3 раза больше токенов. Для служебных инструкций иногда выгоднее английский, а ответы клиенту оставлять на русском.
У большинства сервисов дороже выход, то есть ответ модели. Поэтому многословные ответы бьют по расходу сильнее длинных вопросов, и просить агента отвечать по делу — это тоже экономия.
Зависит от модели оплаты. При прямом подключении к API вы платите за каждый токен, и сумма плавает от месяца к месяцу. На платформе вроде BotHelp AI-токены входят в тариф, а стоимость зависит от числа активных подписчиков — счёт предсказуем заранее.
Да. Есть 14 дней доступа без привязки карты, с лимитом до 3 000 подписчиков и 75 000 AI-токенов — этого хватает, чтобы собрать агента, прогнать реальные диалоги и увидеть фактический расход.
Не обязательно. Урезать историю диалога, лишние документы и многословие можно без потерь. А вот резать защитные правила промпта или базу знаний до состояния «агент молчит» — как раз тот случай, когда экономия выходит дороже.
Хотите увидеть реальный расход токенов на своих диалогах, а не в теории? Соберите ИИ-агента на готовом шаблоне и протестируйте 14 дней бесплатно, без карты.
Статьи в блоге BotHelp создаёт команда практикующих специалистов: маркетологов, продуктовых менеджеров, разработчиков и экспертов с многолетним опытом работы с чат-ботами и мессенджер-маркетингом. Наша цель — давать честные, проверенные практикой ответы на вопросы бизнеса об автоматизации и продажах через мессенджеры.
Технический специалист и эксперт по автоматизации продаж в мессенджерах; построил 50+ прибыльных воронок и помогает бизнесу выстраивать коммуникации с клиентами.